À retenir
Un score dépend des conditions du test. Il faut connaître les questions, les assistants interrogés et la date de l’analyse pour l’interpréter.
Un produit peut être connu sans être recommandé. Un assistant peut savoir le décrire sans le proposer lorsqu’un client demande conseil.
Une recommandation peut reposer sur une erreur. Les arguments et les informations produit doivent être examinés séparément.
L’analyse doit déboucher sur des actions précises. Corriger une confusion entre tailles, compléter une description ou mieux expliquer une fabrication.
Un score ne prédit pas les ventes. Son rapport avec la performance commerciale demande une analyse complémentaire.
Un responsable de collection découvre le résultat d’une analyse : son sac obtient un score de désirabilité IA de 69 sur 100.
La note est fictive, mais les questions qu’elle soulève sont concrètes. Pourquoi 69 ? Quels produits sont mieux recommandés ? Que faudrait-il améliorer ? Et cette note dit-elle quelque chose des chances de vendre ce sac ?
Dans le digital et l’e-commerce, nous avons l’habitude des indicateurs. Un taux de conversion, par exemple, peut sembler satisfaisant ou décevant selon l’origine des visiteurs, le marché ou la période.
Un score de désirabilité IA demande la même attention. Avant de le commenter, il faut comprendre comment il a été obtenu.
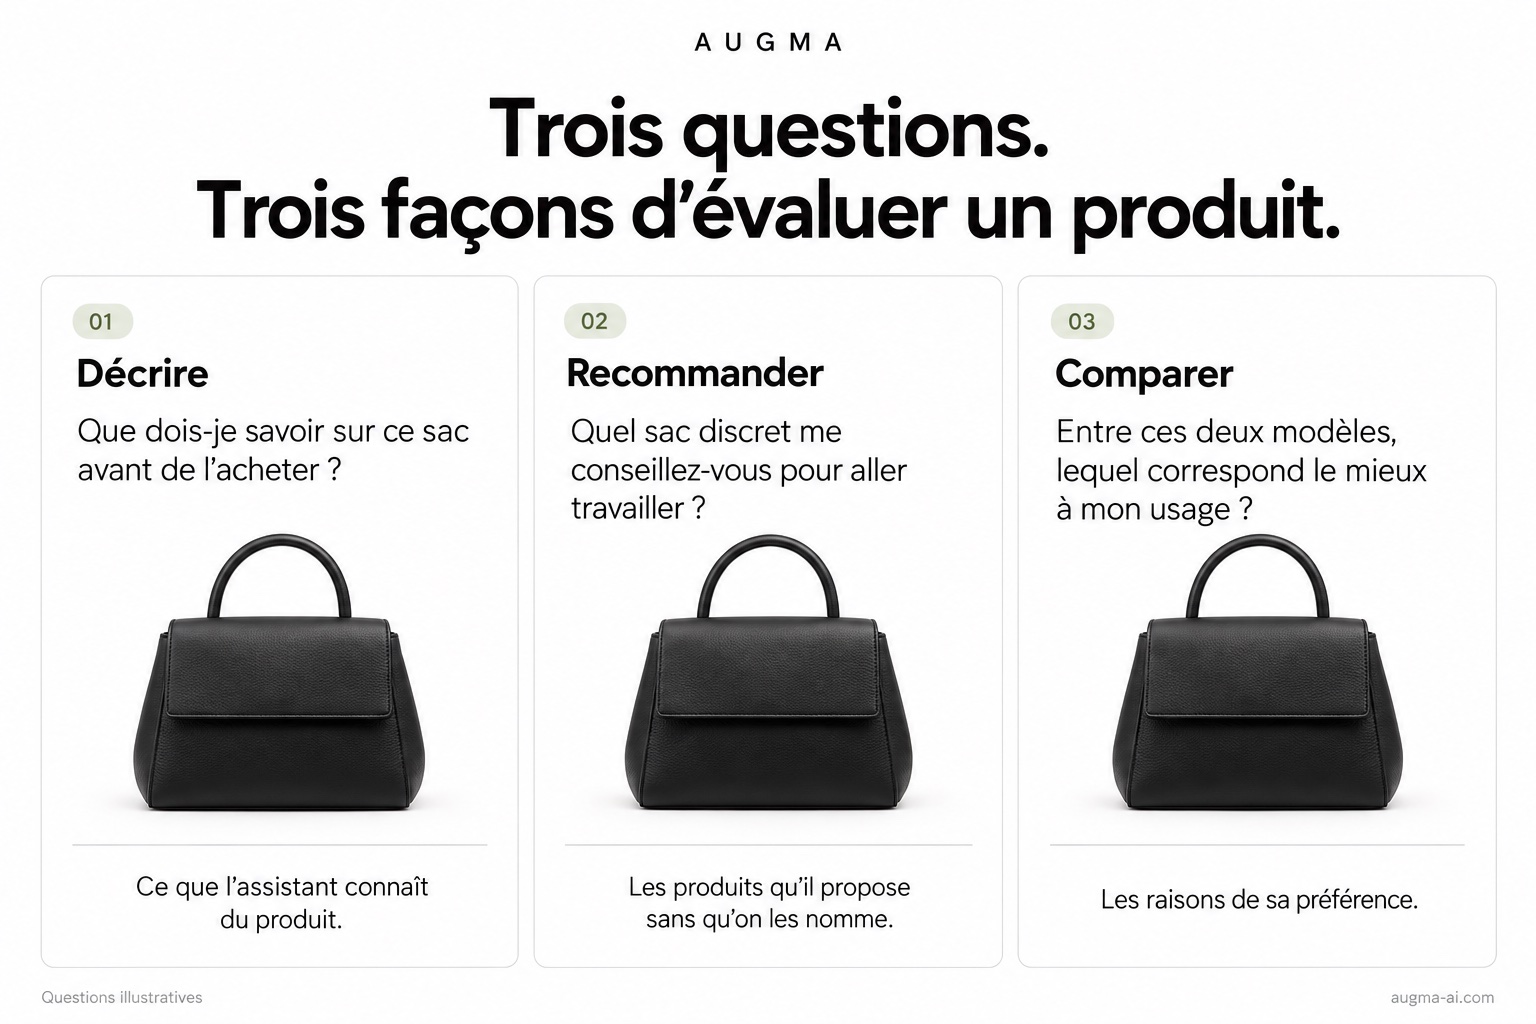
Trois questions, trois tests différents
Le mot « prompt » désigne ici la demande adressée à l’assistant. Sa formulation détermine ce que l’on peut observer.
Prenons trois exemples.
1. Se renseigner sur un produit précis
« Que dois-je savoir sur le sac Loewe Puzzle Edge petit modèle avant de l’acheter ? »
Cette question permet d’examiner la description d’un produit nommé : les caractéristiques mentionnées, les informations exactes, les erreurs et les omissions. Elle ne permet pas de savoir si l’assistant aurait proposé ce sac de lui-même.
2. Demander conseil sans citer de marque
« Je cherche un sac en cuir discret pour tous les jours. Il doit contenir mon téléphone, un petit portefeuille et mes lunettes de soleil, et être confortable à porter en bandoulière. Mon budget est de 3 000 €. Quels modèles me conseillez-vous ? »
L’assistant choisit cette fois les produits qu’il propose. Le sac étudié apparaît-il ? Quelles autres références sont recommandées ? Avec quels arguments ?
3. Comparer deux modèles
« J’hésite entre [sac A, taille précise] et [sac B, taille précise]. Je cherche un modèle léger, avec une fermeture sûre, que je puisse porter en bandoulière pendant plusieurs heures. Lequel me conseillez-vous, et quels sont les avantages et les limites de chacun ? »
Cette demande permet d’étudier les raisons d’une préférence entre des produits identifiés. Si l’assistant affirme que l’un est plus léger ou ferme mieux, ces informations doivent ensuite être vérifiées.
Un même sac peut être décrit correctement dans le premier test, absent du deuxième et préféré dans le troisième. Ces résultats ne disent pas la même chose.
Ces questions illustrent trois types de tests. Elles ne reproduisent pas le protocole d’AUGMA.
Pourquoi ce sac plutôt qu’un autre ?
La présence du produit dans une réponse est un premier constat. Les arguments permettent de comprendre pourquoi il a été proposé.
Imaginons cette explication :
« Sa fermeture zippée protège vos affaires, ce qui en fait un bon choix pour les transports en commun. »
Si le modèle étudié ne possède pas cette fermeture, la recommandation repose en partie sur une erreur. Il faut conserver les deux observations : le sac a été conseillé, mais l’une des raisons données est fausse.
La confusion peut aussi porter sur la taille. Un assistant peut recommander un petit modèle pour transporter un ordinateur en lui attribuant les dimensions d’une version plus grande.
À l’inverse, une description exacte peut rester peu utile. « Cuir de qualité » et « ligne élégante » n’expliquent pas ce qui distingue un modèle ni pourquoi il correspond à la demande.
L’analyse doit donc permettre de retrouver les arguments, de vérifier les faits et, lorsque les sources sont accessibles, d’examiner les informations sur lesquelles l’assistant s’appuie.
La note résume une partie de ce travail. Elle ne dispense pas de lire les réponses.
Dans quelles conditions le produit a-t-il été testé ?
Un sac peut convenir à une journée de travail et beaucoup moins à un voyage. Il peut être proposé à un client qui recherche une pièce classique, puis disparaître des suggestions lorsque la demande porte sur un modèle peu répandu.
Les questions doivent donc correspondre à des situations d’achat plausibles et couvrir plusieurs attentes.
D’autres précisions sont nécessaires : quels assistants ont été interrogés, dans quelle langue et à quelle date ? Avaient-ils accès à la recherche web ? Si le sac a été comparé à d’autres produits, comment ceux-ci ont-ils été sélectionnés ?
Sans ces informations, on risque de prendre pour un jugement général ce qui a été observé dans quelques situations particulières.
Les réponses peuvent également varier lorsque la même question est répétée. Plusieurs observations sont nécessaires pour voir si un résultat se confirme.
Enfin, pour suivre une évolution, il faut conserver des conditions suffisamment comparables. Si les questions ou les assistants changent, une variation de la note peut venir du test lui-même.
Quelles actions engager ?
L’analyse prend son intérêt lorsqu’elle fait apparaître un problème sur lequel les équipes peuvent travailler.
Deux tailles sont régulièrement confondues. Il faut vérifier les noms des variantes, leurs descriptions et les informations reprises par les revendeurs.
Une particularité de fabrication est mal expliquée. Est-elle décrite sur la fiche produit, illustrée par une photographie ou expliquée dans un contenu accessible ? Ou reste-t-elle surtout connue des équipes et des conseillers en boutique ?
Un sac est rarement proposé pour un usage auquel il convient. Il faut examiner les modèles recommandés à sa place et les critères invoqués. Son absence ne prouve pas que sa fiche est insuffisante ; elle donne une question précise à approfondir.
Ces constats appellent des interventions différentes. Une erreur de matière doit être corrigée. Une confusion entre modèles demande une clarification. Un savoir-faire peu compris peut nécessiter un travail éditorial plus approfondi.
L’objectif est de donner aux équipes une liste de problèmes documentés, avec les produits, les réponses et les sources concernés.
Les corrections ont-elles changé les réponses ?
Une fois les contenus repris, il faut poser à nouveau les questions.
La confusion entre les tailles persiste-t-elle ? Les caractéristiques sont-elles mieux décrites ? Le sac est-il conseillé pour des usages auxquels il correspond ?
Une hausse du score ne suffit pas à conclure que tout s’est amélioré. Certaines erreurs peuvent subsister. À l’inverse, la disparition d’une confusion importante peut être utile au client sans faire beaucoup évoluer la note globale.
Conserver les réponses et dater les modifications permet de suivre ces différences. Plusieurs séries de tests aident ensuite à vérifier si l’amélioration se maintient.
Et les ventes ?
Un score de désirabilité IA ne constitue pas une prévision de chiffre d’affaires. Il décrit ce qui a été observé dans les tests.
Pour étudier son rapport avec les ventes, il faut le rapprocher des données commerciales disponibles : visites, consultations des fiches produit, ajouts au panier et achats.
Une partie du parcours peut toutefois échapper à la mesure. Un client peut découvrir un sac auprès d’un assistant, chercher son nom sur Google, puis l’acheter en boutique. Les données du site ne permettront pas nécessairement de relier ces étapes.
Une hausse des recommandations suivie d’une hausse des ventes ne démontre pas non plus un lien de cause à effet. Une campagne, un retour en stock ou un changement de saison peuvent expliquer tout ou partie de cette évolution.
La mesure des recommandations apporte une information supplémentaire sur la façon dont les clients peuvent découvrir les produits. Son effet commercial doit être étudié, pas supposé.
Pourquoi AUGMA
Nous développons AUGMA pour aider les équipes à comprendre comment les assistants présentent une Maison et recommandent ses créations.
L’Index de désirabilité IA compare les Maisons au sein d’une catégorie. Product Check examine un produit précis. Ces analyses portent sur des objets différents : leurs notes ne sont pas directement comparables.
Leur utilité repose sur une même exigence : permettre de retrouver les réponses, de comprendre les arguments et de repérer les informations à reprendre.
Pour les équipes produit, contenu, retail et e-commerce, c’est une base de travail commune. Elles peuvent identifier une confusion, décider comment la corriger, puis observer si elle persiste dans les réponses suivantes.
C’est ce qu’AUGMA vise à rendre possible : passer d’une note à une explication, puis à une action dont on peut suivre les effets.
Découvrez AUGMA et son approche de l’analyse des recommandations IA :